---
title: "6. Enkelvoudige lineaire regressie"
author: "Lieven Clement"
date: "statOmics, Ghent University (https://statomics.github.io)"
format:
html:
toc: true
number-sections: true
theme: cosmo
highlight-style: tango
code-tools: true
embed-resources: true
---
```{r setup, include=FALSE}
knitr::opts_chunk$set(include = TRUE, comment = NA, echo = TRUE,
message = FALSE, warning = FALSE)
library(Rmisc)
library(tidyverse)
```
# Breast cancer dataset
- subset van studie <https://doi.org/10.1093/jnci/djj052>
- 32 borstkanker patiënten met een estrogen recepter positieve tumor die tamoxifen chemotherapy behandeling ondergaan. Variabelen:
- grade: histologische graad van tumor (graad 1 vs 3),
- node: status van de lymfe knopen (0: niet aangetast, 1: aantasting en verwijdering van de lymfe knopen),
- size: grootte van tumor in cm,
- ESR1 en S100A8 gen expressie in tumor biopsy (via microarray technologie)
```{r}
brca <- read_csv("https://raw.githubusercontent.com/statOmics/sbc/master/data/breastcancer.csv")
brca
```
- Om didactische redenen verwijderen we eerst 3 outliers in de S100A8 expressie data.
- In deze studie kan dit echter niet worden verantwoord
- Later in de lessen laten we zien hoe je goed met alle data omgaat.
```{r out.width='70%', fig.align='center',warnings=FALSE}
brca |>
ggplot(aes(x="", y=S100A8)) +
geom_boxplot() +
xlab("") +
ylab("S100A8 expressie")
```
***
```{r}
library(GGally)
brcaSubset <- brca |>
filter(S100A8<2000)
brcaSubset[,-(1:4)] |> ggpairs()
```
## Associatie tussen ESR1 en S100A8 expressie
- ESR1 in $\pm$ 75% van borstkankertumoren.
- Expressie van ER-gen positief voor behandeling: tumor reageert op hormoontherapie
- Tamoxifen interageert met ER en moduleert genexpressie.
- Eiwitten van de S100-familie zijn vaak gedisreguleerd bij kanker
- S100A8 expressie onderdrukt immuunsysteem in tumor en creëert inflamatoir milieu die kankergroei promoot.
- Interesse in associatie tussen ESR1 en S100A8 expressie.
1. pipe dataset naar ggplot
2. selecteer data `ggplot(aes(x=ESR1,y=S100A8))`
3. voeg punten toe met `geom_point()`
4. voeg een "smooth line" toe `geom_smooth()`
```{r fig.align='center'}
brcaSubset |>
ggplot(aes(x=ESR1,y=S100A8)) +
geom_point() +
geom_smooth()
```
# Lineaire Regressie
- Statistische methode om relatie tussen 2 reeksen observaties $(X_i, Y_i)$, bekomen voor onafhankelijke subjecten $i = 1, ..., n$, te beschrijven.
- Gen expressie voorbeeld
- Response Y : S100A8 expressie
- Predictor X: ESR1 expressie
1. pipe dataset naar ggplot
2. selecteer data `ggplot(aes(x=ESR1,y=S100A8))`
3. voeg punten toe met `geom_point()`
4. voeg een "smooth line" toe `geom_smooth()`
5. voeg een rechte toe `geom_smooth()` met `method = "lm"` (linear model). (We zetten `se = FALSE` om geen puntgewijze betrouwbaarheidsintervallen weer te geven)
```{r fig.align='center'}
brcaSubset |>
ggplot(aes(x = ESR1,y = S100A8)) +
geom_point() +
geom_smooth(se = FALSE, col = "grey") +
geom_smooth(method = "lm", se = FALSE)
```
## Model
- Voor vaste $X$, heeft $Y$ niet noodzakelijke dezelfde waarde
$$\text{observation = signal + noise}$$
$$Y_i=g(X_i)+\epsilon_i$$
- We definiëren $g(x)$ als het verwachte resultaat voor subjects met $X_i=x$
$$E[Y_i|X_i=x]=g(x)$$
Daarom is $\epsilon_i$ gemiddeld 0 voor subjects met dezelfde $X_i$:
$$E[\epsilon_i|X_i]=0$$
## Lineaire regressie
- Om **accurate** en **interpreteerbare** resultaten te bekomen, kiest men $g(x)$ vaak als een lineaire functie met ongekende parameters.
$$E(Y|X=x)=\beta_0 + \beta_1 x$$
onbekend **intercept** $\beta_0$ en
**helling** $\beta_1$.
- Lineair model legt een *assumptie* op de verdeling van $X$ en $Y$, die incorrect kan zijn.
- *Efficiënte data-analyse*: benut alle observaties om iets te leren over verwachte uitkomst bij $X=x$.
## Gebruik
- *Predictie*: wanneer $Y$ ongekend is, maar $X$ wel, kunnen we $Y$ voorspellen op basis van $X$
\[E(Y|X=x)=\beta_0 + \beta_1 x\]
- *Associatie*: biologische relatie tussen variabele $X$ en continue meting $Y$ beschrijven.
- *Intercept:* $E(Y|X=0)=\beta_0$
- *Slope*:
\begin{eqnarray*}
E(Y|X=x+\delta)-E(Y|X=x)&=&\beta_0 + \beta_1 (x+\delta) -\beta_0-\beta_1 x\\
&=& \beta_1\delta
\end{eqnarray*}
$\beta_1:$ verschil in gemiddelde uitkomst voor subjecten die verschillen in één eenheid van de predictor $X$.
# Parameterschatting
- - Kleinste kwadraten techniek
(Least squares)
```{r fig.align='center'}
brcaSubset |>
ggplot(aes(x = ESR1, y = S100A8)) +
geom_point() +
geom_smooth(se = FALSE, col = "grey") +
geom_smooth(method = "lm", se = FALSE)
```
- Parameters $\beta_0$ en $\beta_1$ zijn ongekend
- Parameters schatten op basis van beperkte steekproef
- Best passende lijn
- Punt op regressielijn voor een gegeven $x_i$: $(x_i, \beta_0 + \beta_1 x_i)$ zo dicht mogelijk bij $(x_i, y_i)$
- Kies $\beta_0$ en $\beta_1$ zodat de som tussen voorspelde en waargenomen punten zo klein mogelijk wordt.
$$SSE=\sum_{i=1}^n (y_i-\beta_0-\beta_1 x_i)^2=\sum_{i=1}^n e_i^2$$
- Met $e_i$ de residuen: de verticale afstanden van de observaties tot de gefitte regressierechte
## Schatters die SSE minimaliseren
$$\hat{\beta_1}= \frac{\sum\limits_{i=1}^n (y_i-\bar y)(x_i-\bar x)}{\sum\limits_{i=1}^n (x_i-\bar x)^2}=\frac{\mbox{cor}(x,y)s_y}{s_x} $$
$$\hat{\beta_0}=\bar y - \hat{\beta}_1 \bar x $$
- Merk op dat de helling van de kleinste kwadratenlijn evenredig is met de correlatie tussen de uitkomst en de verklarende variabele.
Geschatte lineaire regressiemodel laat toe om:
- verwachte uitkomst te voorspellen voor subjecten met een gegeven waarde $x$ voor de predictor:
$$\text{E} [ Y | X = x]=\hat{\beta}_0+\hat{\beta}_1x$$
- na te gaan hoeveel uitkomst gemiddeld verschilt tussen 2 groepen subjecten met een verschil van $\delta$ eenheden in de verklarende variabele:
$$\text{E}\left[Y|X=x+\delta\right]-\text{E}\left[Y|X=x\right]= \hat{\beta}_1\delta$$
### Borstkanker voorbeeld
```{r}
lm1 <- lm(S100A8 ~ ESR1, brcaSubset)
summary(lm1)
```
\[E(Y|X=x)=`r round(lm1$coef[1],2)`-`r abs(round(lm1$coef[2],3))` x\]
- De verwachte S100A8-expressie is gemiddeld `r abs(round(lm1$coef[2],3)*1000)` eenheden lager voor patiënten met een ESR1-expressieniveau die 1000 eenheden hoger ligt.
- Verwachte S100A8 expressieniveau voor patiënten met een ESR1 expressieniveau van 2000:
\[`r round(lm1$coef[1],2)`-`r abs(round(lm1$coef[2],3))`\times 2000=`r round(lm1$coef[1]+lm1$coef[2]*2000,2)`\]
- Verwachte S100A8 expressieniveau voor patiënten met een ESR1 expressieniveau van 4000:
\[`r round(lm1$coef[1],2)`-`r abs(round(lm1$coef[2],3))`\times 4000=`r round(lm1$coef[1]+lm1$coef[2]*4000,2)`\]
- **Let op voor extrapolatie!** (Veronderstelling van lineariteit kan men enkel nagaan binnen het bereik van de data).
# Statistische besluitvorming (statistische inferentie)
Om besluiten te kunnen trekken over lineaire regressiemodel
\[E(Y|X)=\beta_0+\beta_1 X\]
moeten we weten:
- Hoe de least squares parameter schatters variëren van steekproef tot steekproef, en
- En hoe is dit onder de nulhypothese dat er geen associatie is tussen predictor en response
- Noodzaak aan statistisch model!
- Modelleer de verdeling van $Y$ gegeven $X$ expliciet: $f_{Y|X}(y)$
## Modelleer verdeling van Y?
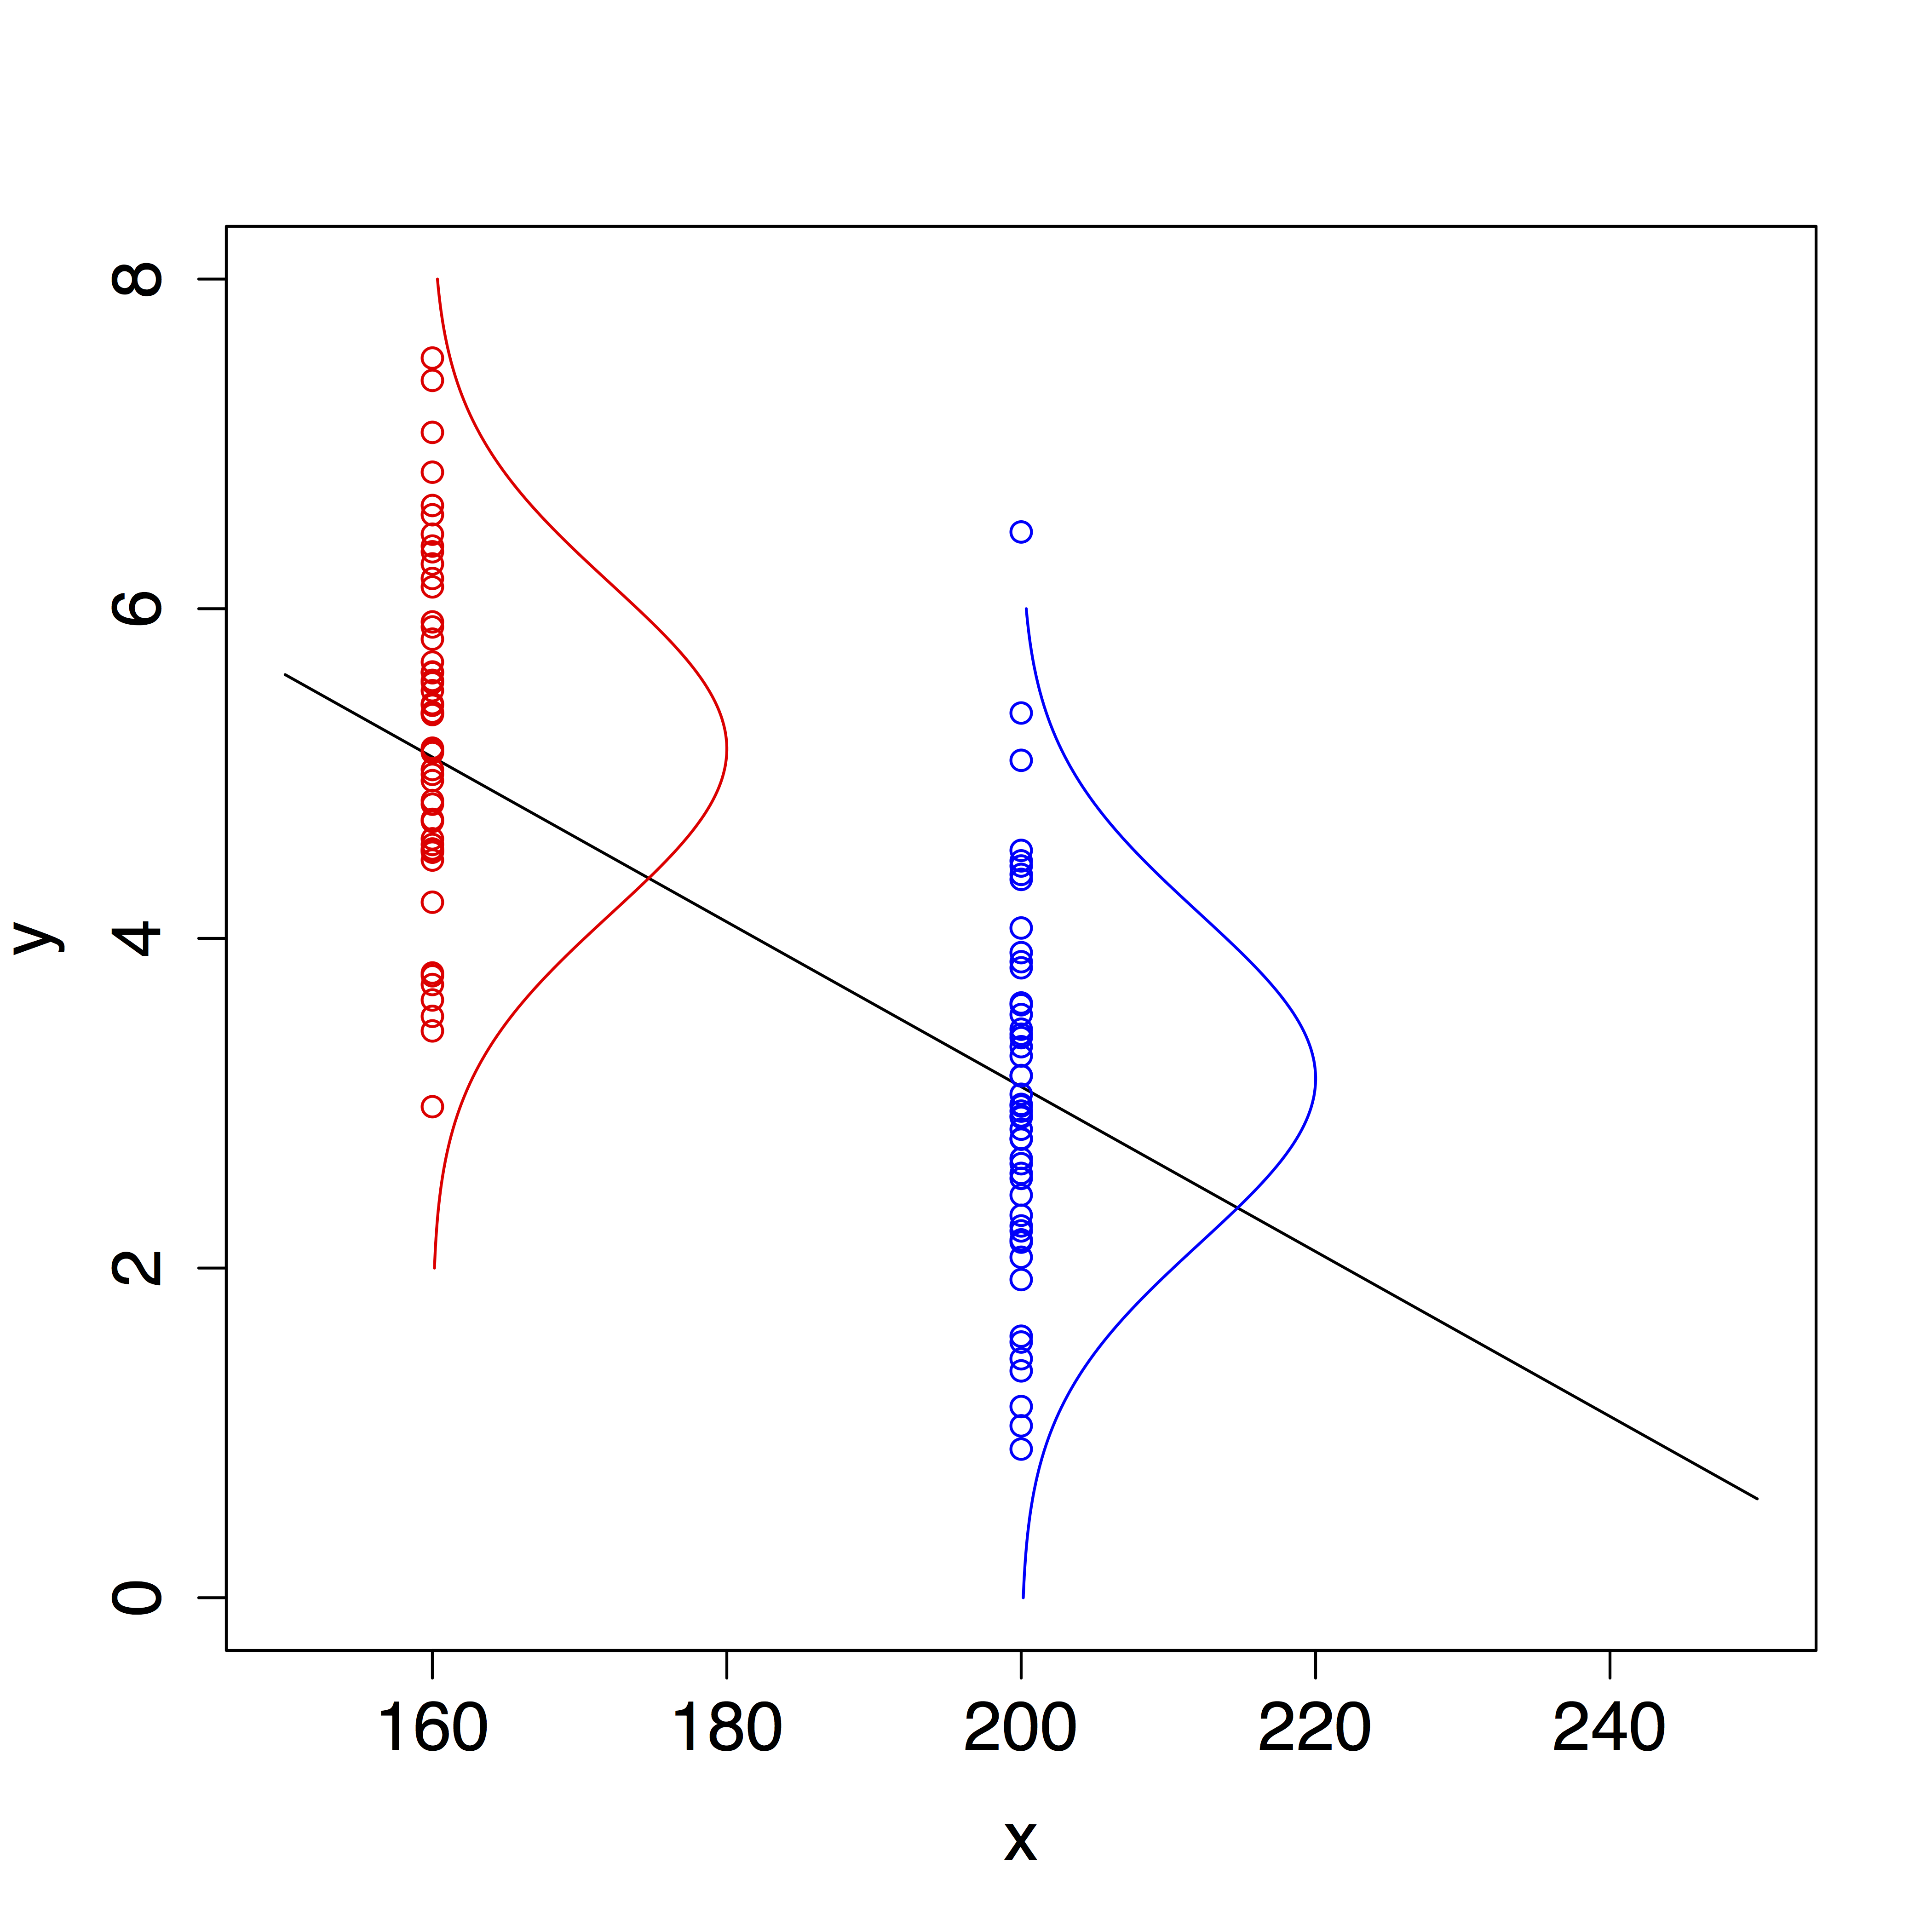
1. Naast *lineariteit* hebben we nog aannames nodig!
2. *Onafhankelijkheid*: waarnemingen $(X_1,Y_1), ..., (X_n,Y_n)$ zijn gemaakt voor n onafhankelijke subjecten (Is vereist om de variantie te schatten)
3. *Homoscedasticiteit * of *gelijke varianties*: waarnemingen variëren met gelijk gemiddelde rond de regressielijn.
- Residuen $\epsilon_i$ hebben gelijke variantie voor elke $X_i=x$
- $\text{var}(Y\vert X=x) = \sigma^2$ voor elke $X=x$
- $\sigma$ wordt de *residuele standaarddeviatie* genoemd.
4. *Normaliteit*: de residuen $\epsilon_i$ zijn normaal verdeeld
{width=100%}
- Uit 2, 3 en 4 volgt dat
$$\epsilon_i \text{ i.i.d.} N(0,\sigma^2).$$
- Als we ook steunen op eerste veronderstelling van lineariteit:
$$Y_i\vert X_i\sim N(\beta_0+\beta_1 X_i,\sigma^2),$$
- Verder kan men aantonen dat onder deze aannames
$$\sigma^2_{\hat{\beta}_0}=\frac{\sum\limits_{i=1}^n X^2_i}{\sum\limits_{i=1}^n (X_i-\bar X)^2} \times\frac{\sigma^2}{n} \text{ en } \sigma^2_{\hat{\beta}_1}=\frac{\sigma^2}{\sum\limits_{i=1}^n (X_i-\bar X)^2}$$
- en dat de parameterschatters eveneens normaal verdeeld zijn
$$\hat\beta_0 \sim N\left(\beta_0,\sigma^2_{\hat \beta_0}\right) \text{ en } \hat\beta_1 \sim N\left(\beta_1,\sigma^2_{\hat \beta_1}\right)$$
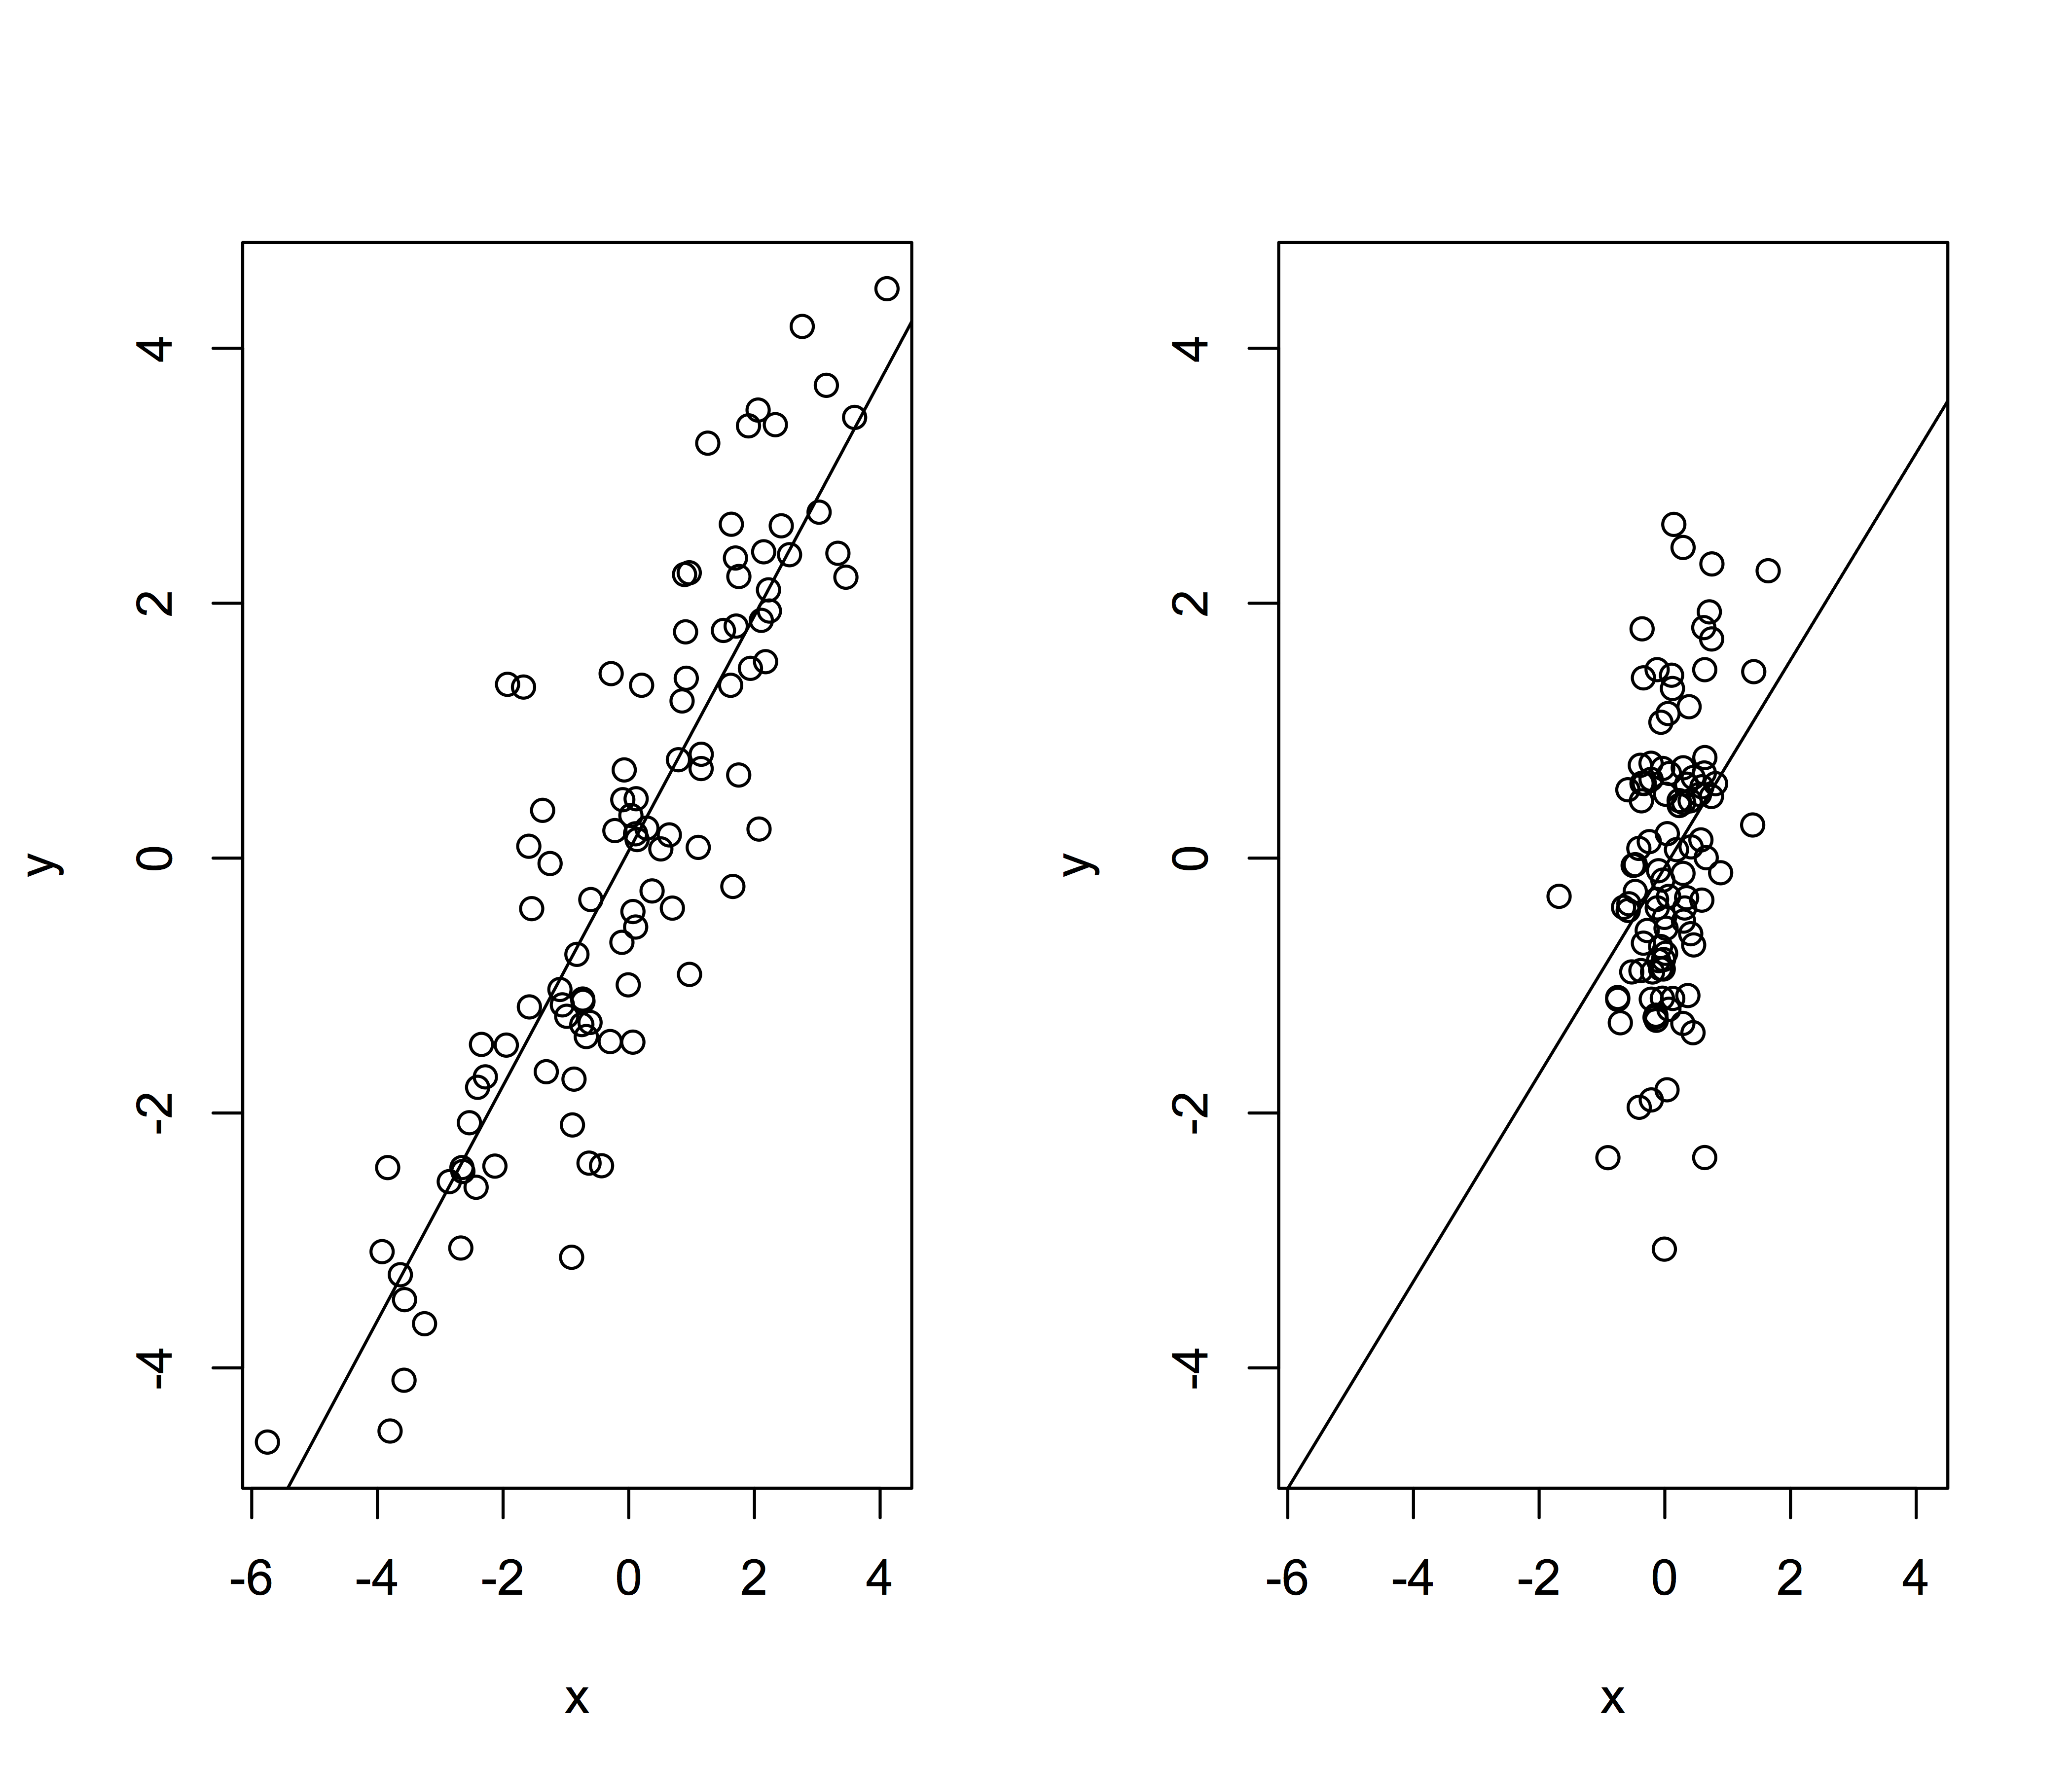
## Hoge spreiding op $X$ verbetert de precisie
$$\sigma^2_{\hat{\beta}_1}=\frac{\sigma^2}{\sum\limits_{i=1}^n (X_i-\bar X)^2}$$
{ width=100% }
- Conditionele variantie ($\sigma^2$) is niet gekend
- Schatten d.m.v. gemiddelde van die kwadratische afwijkingen rond de regressierechte
- *mean squared error* (MSE)
$$\hat\sigma^2=MSE=\frac{\sum\limits_{i=1}^n \left(y_i-\hat\beta_0-\hat\beta_1\times x_i\right)^2}{n-2}=\frac{\sum\limits_{i=1}^n e^2_i}{n-2}.$$
- Voor het bekomen van deze schatter steunen we op onafhankelijkheid (aanname 2) en homoscedasticiteit (aanname 3).
- deel door $n-2$
Na schatting van $\sigma^2$ bekomen we volgende standaard errors:
$$\text{SE}_{\hat{\beta}_0}=\hat\sigma_{\hat{\beta}_0}=\sqrt{\frac{\sum\limits_{i=1}^n X^2_i}{\sum\limits_{i=1}^n (X_i-\bar X)^2} \times\frac{\text{MSE}}{n}} \text{ en } \text{SE}_{\hat{\beta}_1}=\hat\sigma_{\hat{\beta}_1}=\sqrt{\frac{\text{MSE}}{\sum\limits_{i=1}^n (X_i-\bar X)^2}}$$
- Opnieuw toetsen en betrouwbaarheidsintervallen o.b.v.
$$T=\frac{\hat{\beta}_k-\beta_k}{SE(\hat{\beta}_k)} \text{ with } k=1,2.$$
- Als aan alle aannames is voldaan volgt $T$ een t-verdeling met n-2 vrijheidsgraden.
- Als geen normaliteit maar wel onafhankelijk, lineariteit en homoscedasticiteit en grote dataset
\[\rightarrow \text{Centrale Limietstelling}\]
### Borstkanker voorbeeld
- Negatieve associatie tussen S100A8 en ESR1 gen expressie.
- Veralgemeen effect in steekproef naar populatie met behulp van het betrouwbaarheidsinterval op de helling:
$$[\hat\beta_1 - t_{n-2,\alpha/2} \text{SE}_{\hat\beta_1},\hat\beta_1 + t_{n-2,\alpha/2} \text{SE}_{\hat\beta_1}]$$.
```{r}
confint(lm1)
```
- Negatief verband is significant op het 5% significantieniveau.
## Hypothese test
- Vertaal de onderzoeksvraag "Is er een associatie tussen de S100A8- en ESR1-genexpressie?" naar de parameters in het model.
- Onder nulhypothese geen associatie tussen expressie van beide genen:
$$H_0: \beta_1=0$$
- Onder alternatieve hypothese is er een associatie tussen beide genen:
$$H_1: \beta_1\neq0$$
- Test statistiek
$$T=\frac{\hat{\beta}_1-0}{SE(\hat{\beta}_k)}$$
- Onder $H_0$ volgt de statistiek een t-verdeling met n-2 vrijheidsgraden.
### Brca dataset
```{r}
summary(lm1)
```
- Associatie tussen de S100A8 en ESR1 genexpressie extreem significant is (p<<0.001).
- Maar eerst moeten we alle assumpties controleren!
- Anders kunnen de conclusies o.b.v. de statistische test en het BI onjuist zijn.
# Nagaan van modelveronderstellingen
- Onafhankelijkheid: design
- Lineariteit: besluitvorming geen zin als model niet lineair is
- Homoscedasticiteit: besluitvorming/p-waarde is niet betrouwbaar als de data niet homoscedastisch zijn
- Normaliteit: besluitvorming/p-waarde is niet betrouwbaar als de data niet normaal verdeeld zijn in kleine steekproeven
## Lineariteit
```{r fig.align='center'}
brcaSubset |>
ggplot(aes(x = ESR1, y = S100A8)) +
geom_point() +
geom_smooth(se = FALSE, col = "grey") +
geom_smooth(method = "lm", se = FALSE)
```
## Residuplots
- Afwijkingen van lineariteit echter makkelijker opgespoord d.m.v. een *residuplot*. (Zeker als er later meer variabelen zijn in het lineaire model)
- verklarende variabele of predicties $\hat\beta_0+\hat\beta_1 x$ op de $X$-as
- de *residuen* op de $Y$-as
$$e_i=y_i-\hat{g}(x_i)=y_i-\hat\beta_0-\hat\beta_1\times x_i,$$
```{r}
plot(lm1)
```
## Homoscedasticiteit (gelijkheid van variantie)
- Residuen en kwadratische residu’s dragen informatie over residuele variabiliteit.
- Associatie met de verklarende variabelen $\rightarrow$ indicatie van heteroscedasticiteit.
- Scatterplot van of $e_i$ versus $x_i$ of predicties $\hat \beta_0+ \hat \beta_1 x_i$.
- Scatterplot van gestandaardiseerd residu versus $x_i$ of predicties.
## Normaliteit
- Indien voldoende gegevens, schatters normaal verdeeld zelfs wanneer observaties niet Normaal verdeeld zijn: centrale limiet stelling
- Wat ‘voldoende observaties’ zijn, hangt af van hoe goed de verdeling op de Normale lijkt.
- Aanname is dat uitkomsten Normaal verdeeld zijn bij vaste waarden van de verklarende variabelen.
$$Y_i\vert X_i\sim N(\beta_0+\beta_1X_i,\sigma^2)$$
- QQ-plot van response Y is heel misleidend.
- QQ-plot van de residuen $e_i$
```{r echo=FALSE}
set.seed <- 200
par(mfrow=c(1,3))
x <- rep(1:10,each=20)
y <- x+rnorm(length(x))
boxplot(y~x)
qqnorm(y, main="Original observations")
qqline(y)
lmH <- lm(y~x)
plot(lmH, which=2, main="Residuals")
```
```{r}
plot(lm1, which=2)
```
# Afwijkingen van Modelveronderstellingen
- Transformatie van onafhankelijke veranderlijke wijzigt de verdeling van Y bij gegeven X niet:
- helpt niet om normaliteit of homoscedasticiteit te bekomen
- helpt wel om lineariteit te bekomen wanneer er normaliteit en homoscedasticiteit is
- Vaak ook hogere orde termen: $X^2$, $X^3$, ...
$$Y_i=\beta_0+\beta_1X_i+\beta_2X_i^2+ ... + \epsilon_i$$
- Transformatie van response Y kan helpen om normaliteit en homoscedasticiteit te bekomen.
- $\sqrt(Y)$, $\log(Y)$, 1/Y, ...
## Borstkanker voorbeeld
Problemen met
- heteroscedasticiteit
- mogelijkse afwijking van normaliteit (scheefheid naar rechts)
- negatieve concentratievoorspellingen die theoretisch niet mogelijk zijn
- niet-lineairiteit
- treedt veelal op bij concentratie en intensiteitsmetingen
- Deze zijn vaak log-normaal verdeeld (normale verdeling na log-transformatie)
- In Figuur 6.3 eveneens een soort exponentiële trend
- In de genexpressie literatuur wordt veelal gebruik gemaak van $\log_2$ transformatie
- gen-expressie op log-schaal proportionele verschillen op de originele schaal
```{r}
brca |>
ggplot(aes(x = ESR1, y = S100A8)) +
geom_point() +
geom_smooth()
```
```{r}
brca |>
ggplot(aes(
x = ESR1 |> log2(),
y = S100A8 |> log2())
) +
geom_point() +
geom_smooth()
```
```{r}
lm2<-lm(S100A8 |> log2() ~ ESR1 |> log2(), brca)
plot(lm2)
summary(lm2)
```
```{r}
confint(lm2)
```
### Interpretatie 1
Een patiënt met een ESR1 expressie die 1 eenheid op de $\log_2$ schaal hoger ligt dan dat van een andere patiënt heeft gemiddeld gezien een expressie-niveau van het S100A8 gen dat `r abs(round(lm2$coef[2],2))` eenheden lager ligt (95\% BI [`r paste(round(confint(lm2)[2,],2),collapse=",")`]).
**Crossectionele studie: enkel uitspraken over verschillen tussen patiënten!**
$$\log_2 \hat\mu_1=23.401 -1.615 \times \text{logESR}_1,\text{ } \log_2 \hat\mu_2=23.401 -1.615 \times \text{logESR}_2 $$
$$\log_2 \hat\mu_2-\log_2 \hat\mu_1= -1.615 (\log_2 \text{ESR}_2-\log_2 \text{ESR}_1) = -1.615 \times 1 = -1.615$$
### Interpretatie 2
Model op log-schaal: bij terugtransformatie verkrijgen we het geometrische gemiddelde
\begin{eqnarray*}
\sum\limits_{i=1}^n \frac{\log x_i}{n}&=&\frac{\log x_1 + \ldots + \log x_n}{n}\\\\
&\stackrel{(1)}{=}&\frac{\log(x_1 \times \ldots \times x_n)}{n}=\frac{\log\left(\prod\limits_{i=1}^n x_i\right)}{n}\\\\
&\stackrel{(2)}{=}&\log \left(\sqrt[\leftroot{-1}\uproot{2}\scriptstyle n]{\prod\limits_{i=1}^n x_i}\right)
\end{eqnarray*}
- Populatiegemiddelden $\mu$ dus geschat a.d.h.v. geometrisch gemiddelden.
- Logaritmische transformatie is een monotoon: we kunnen betrouwbaarheidsintervallen berekend op log-schaal terugtransformeren!
```{r}
2^lm2$coef[2]
2^-lm2$coef[2]
2^-confint(lm2)[2,]
```
Een patiënt met een ESR1 expressie die 2 keer zo hoog is als die van een andere patiënt, zal gemiddeld een S100A8-expressie hebben die `r round(2^-lm2$coef[2]
,2)` keer lager is (95\% BI [`r paste(sort(round(2^-confint(lm2)[2,],2)),collapse=",")`]).
$$\log_2 \hat\mu_1=23.401 -1.615 \times \text{logESR}_1,\text{ } \log_2 \hat\mu_2=23.401 -1.615 \times \text{logESR}_2 $$
$$\log_2 \hat\mu_2-\log_2 \hat\mu_1= -1.615 (\log_2 \text{ESR}_2-\log_2 \text{ESR}_1) $$
$$\log_2 \left[\frac{\hat\mu_2}{\hat\mu_1}\right]= -1.615 \log_2\left[\frac{ \text{ESR}_2}{\text{ESR}_1}\right] $$
$$\frac{\hat\mu_2}{\hat\mu_1}=\left[\frac{ \text{ESR}_2}{\text{ESR}_1}\right]^{-1.615}=2^ {-1.615} =0.326$$
or
$$\frac{\hat\mu_1}{\hat\mu_2}=2^{1.615} =3.06$$
### Interpratie 3
Een patiënt met een ESR1 expressie die 1\% hoger is dan die van een andere patiënt zal gemiddeld een expressieniveau voor het S100A8 gen hebben dat ongeveer `r round(lm2$coef[2],2)`% lager is (95\% BI [`r paste(round(confint(lm2)[2,],2),collapse=",")`])%.
$$\log_2 \hat\mu_1=23.401 -1.615 \times \text{logESR}_1,\text{ } \log_2 \hat\mu_2=23.401 -1.615 \times \text{logESR}_2 $$
$$\log_2 \hat\mu_2-\hat\log_2 \mu_1= -1.615 (\log_2 \text{ESR}_2-\log_2 \text{ESR}_1) $$
$$\log_2 \left[\frac{\hat\mu_2}{\hat\mu_1}\right]= -1.615 \log_2\left[\frac{ \text{ESR}_2}{\text{ESR}_1}\right] $$
$$\frac{\hat\mu_2}{\hat\mu_1}=\left[\frac{ \text{ESR}_2}{\text{ESR}_1}\right]^{-1.615}=1.01^ {-1.615} =0.984 \approx -1.6\%$$
Dit geldt voor lage tot matige waarden van $\beta_1$:
$$-10<\beta_1<10 \rightarrow 1.01^{\beta_1} -1 \approx \frac{\beta_1}{100}.$$
# Besluitvorming over gemiddelde uitkomst
- Regressie model kan ook worden gebruikt voor predictie
- Besluitvorming te doen over de gemiddelde uitkomst bij een gegeven waarde $x$, m.a.w.
$$\hat{g}(x)= \hat{\beta}_0 + \hat{\beta}_1 x$$
- $\hat{g}(x)$ een schatter van het conditionele gemiddelde $E[Y\vert X=x]$
- Parameterschatters Normale verdeeld en onvertekend $\rightarrow$ schatter $\hat{g}(x)$ ook Normaal verdeeld en onvertekend.
$$\text{SE}_{\hat{g}(x)}=\sqrt{MSE\left\{\frac{1}{n}+\frac{(x-\bar X)^2}{\sum\limits_{i=1}^n (X_i-\bar X)^2}\right\}}.$$
$$T=\frac{\hat{g}(x)-g(x)}{SE_{\hat{g}(x)}}\sim t_{n-2}$$
- Gemiddelde uitkomst en betrouwbaarheidsintervallen op de gemiddelde uitkomst in R via de `predict(.)` functie.
- `newdata` argument: predictorwaarden (x-waarden) voor het berekenen van gemiddelde uitkomsten
- `interval="confidence"` argument om betrouwbaarheidsintervallen te bekomen.
- Zonder `newdata` argument wordt de gemiddelde uitkomsten berekend voor alle predictorwaarden van de dataset.
```{r}
grid <- 140:4000
g <- predict(
lm2,
newdata = data.frame(ESR1 = grid),
interval = "confidence")
head(g)
```
Merk op dat we de nieuwe data die we gespecificeerd hebben voor de ESR1 expressie niet moeten transformeren omdat we het model fitten met de `lm`functie en de transformatie hebben gespecificeerd binnen die functie met behulp van het pipe commando!
```{r}
brca |> ggplot(
aes(
x = ESR1 |> log2(),
y = S100A8 |> log2())
) +
geom_point() +
geom_smooth(method = "lm")
```
## Terugtransformatie
```{r}
newdata<-data.frame(cbind(grid,2^g))
brca |>
ggplot(aes(x = ESR1, y = S100A8)) +
geom_point() +
geom_line(aes(x=grid,y=fit),newdata) +
geom_line(aes(x=grid,y=lwr),newdata,color="grey") +
geom_line(aes(x=grid,y=upr),newdata,color="grey")
```
# Predictie-intervallen
-We kunnen ook een voorspelling doen voor de locatie van een nieuwe waarneming die zou worden verzameld in een nieuw experiment voor een patiënt met een bepaalde waarde voor hun ESR1-expressie
- Het is belangrijk op te merken dat dit experiment nog moet worden uitgevoerd. We willen dus de niet-waargenomen individuele expressiewaarde voor een nieuwe patiënt voorspellen.
- Voor een nieuwe onafhankelijke waarneming $Y^*$
$$
Y^* = g(x) + \epsilon^*
$$
met $\epsilon^*\sim N(0,\sigma^2)$ en $\epsilon^*$ onafhankelijk van de waarnemingen in de steekproef $Y_1,\ldots, Y_n$.
- We voorspellen een nieuwe log-S100A8 voor een patiënt met een gekend log2-ESR1-expressieniveau x
\[
\hat{y}(x)=\hat{\beta}_0+\hat{\beta}_1 \times x
\]
- De geschatte gemiddelde uitkomst en voorspelling voor een nieuwe waarneming zijn gelijk.
- Maar hun steekproef verdelingen zijn anders!
- Onzekerheid over de geschatte gemiddelde uitkomst $\leftarrow$ onzekerheid over de geschatte modelparameters $\hat\beta_0$ en $\hat\beta_1$.
- Onzekerheid over nieuwe waarneming $\leftarrow$ *onzekerheid over geschat gemiddelde* en *extra onzekerheid* omdat de nieuwe waarneming zal afwijken rond het gemiddelde!
$$\text{SE}_{\hat{Y}(x)}=\sqrt{\hat\sigma^2+\hat\sigma^2_{\hat{g}(x)}}=\sqrt{MSE\left\{1+\frac{1}{n}+\frac{(x-\bar X)^2}{\sum\limits_{i=1}^n (X_i-\bar X)^2}\right\}}.$$
$$\frac{\hat{Y}(x)-Y}{\text{SE}_{\hat{Y}(x)}}\sim t_{n-2}$$
- Merk op dat een **predictie-interval** (PI) een verbeterde versie is van een referentie-interval wanneer de modelparameters onbekend zijn: onzekerheid over modelparameters + t-verdeling.
```{r}
p <- predict(
lm2,
newdata = data.frame(ESR1 = grid),
interval="prediction")
head(p)
```
```{r}
preddata<-data.frame(
grid = grid|>log2(),
p)
brca |> ggplot(aes(x=ESR1|>log2(),y=S100A8|>log2())) +
geom_point() +
geom_smooth(method="lm") +
geom_line(aes(x=grid,y=lwr),preddata,color="blue") +
geom_line(aes(x=grid,y=upr),preddata,color="blue")
```
```{r}
preddata<-data.frame(cbind(grid,2^p))
brca |> ggplot(aes(x = ESR1, y = S100A8)) +
geom_point() +
geom_line(
aes(x = grid,y = fit),
newdata) +
geom_line(
aes(x = grid, y = lwr),
newdata,
color = "grey") +
geom_line(
aes(x = grid, y = upr),
newdata,
color = "grey") +
geom_line(
aes(x = grid, y = lwr),
preddata,
color = "blue") +
geom_line(
aes(x = grid,y = upr),
preddata,
color = "blue")
```
## NHANES voorbeeld
- Vergelijk referentie-interval voor cholesterolgehalte met predictie interval.
- Referentie-interval
```{r}
library(NHANES)
fem <- NHANES |>
filter(Gender=="female"&!is.na(DirectChol))
2^(
fem |>
pull(DirectChol) |>
log2() |>
mean() +
c(-1,1) *
qnorm(0.975) *
(fem |>
pull(DirectChol) |>
log2() |>
sd())
)
```
- Predictie interval
```{r}
lmChol <- lm(DirectChol |> log2() ~ 1, data=fem)
predInt <- predict(
lmChol,
interval="prediction",
newdata=data.frame(noPred=1)
)
round(2^predInt,2)
```
Merk op dat het voorspellingsinterval bijna gelijk is aan het referentie-interval voor de grote steekproef. We konden de parameters inderdaad heel precies schatten.
We zullen hetzelfde doen voor een kleine steekproef van 10 patiënten.
- Referentie interval
```{r}
set.seed(1)
fem10 <- NHANES |>
filter(Gender=="female"&!is.na(DirectChol)) |>
sample_n(size=10)
2^(
fem10 |>
pull(DirectChol) |>
log2() |>
mean() +
c(-1,1) *
qnorm(0.975) *
(fem10 |>
pull(DirectChol) |>
log2() |>
sd())
)
```
Het referentie-interval is veel smaller dan in de grote steekproef.
- Predictie interval
```{r}
lmChol10 <- lm(DirectChol |> log2() ~ 1, data = fem10)
predInt10 <- predict(
lmChol10,
interval = "prediction",
newdata = data.frame(noPred=1)
)
round(2^predInt10, 2)
```
- Merk op dat het PI nu onzekerheid meeneemt in parameterschatters (gemiddelde en standaard error).
En dat het interval veel breder wordt! Dit is hier vooral belangrijk voor de bovengrens omdat we de gegevens terug hebben getransformeerd!
- Het interval is bijna net zo breed als dat gebaseerd op de grote steekproef.
- Bij kleine steekproeven is het erg belangrijk om met deze extra onzekerheid rekening te houden.
# Kwadratensommen en Anova-tabel
## Totale kwadratensom
$$\text{SSTot} = \sum_{i=1}^n (Y_i-\bar{Y})^2.$$
- SStot kan worden gebruikt om de variantie van de **marginale verdeling** van de respons te schatten.
- In dit hoofdstuk hebben we ons gefocused op de **conditionele verdeling** $f(Y\vert X=x)$.
- We weten dat MSE een goede schatting is van de variantie van de conditionele verdeling van $Y\vert X=x$.
```{r out.width='100%', fig.asp=.8, fig.align='center', echo=FALSE}
brca$log2ESR1 <- log2(brca$ESR1)
brca$log2S100A8 <- log2(brca$S100A8)
plot(log2S100A8 ~ log2ESR1,
data = brca,
xlab = "ESR1 expressie (log2)",
ylab = "S100A8 expressie (log2)",
cex.axis=1.5,
cex.main=1.5,
cex.lab=1.5,col=4)
abline(h = mean(brca$log2S100A8))
for (i in 1:length(brca$log2S100A8)) lines(rep(brca$log2ESR1[i],2),c(mean(brca$log2S100A8),brca$log2S100A8[i]),lty=2,col=4)
```
## Kwadratensom van de regressie SSR
$$\text{SSR} = \sum_{i=1}^n (\hat{Y}_i - \bar{Y})^2 = \sum_{i=1}^n (\hat{g}(x_i) - \bar{Y})^2.$$
- Maat voor de afwijking tussen de predicties op de geschatte regressierechte en het steekproefgemiddelde van de uitkomsten.
- Een andere interpretatie: verschil tussen twee modellen
- Geschatte model $\hat{g}(x)=\hat\beta_0+\hat\beta_1x$
- Geschatte model zonder predictor (enkel intercept): $g(x)=\beta_0$ $\rightarrow$ $\beta_0$ zal gelijk zijn aan $\bar{Y}$.
- SSR meet de grootte van het effect van de predictor
```{r out.width='100%', fig.asp=.8, fig.align='center',echo=FALSE}
plot(log2S100A8~log2ESR1,brca,xlab="ESR1 expressie (log2)",ylab="S100A8 expressie (log2)",cex.axis=1.5,cex.main=1.5,cex.lab=1.5)
abline(h=mean(brca$log2S100A8))
abline(lm2,col=2)
points(brca$log2ESR1,lm2$fitted,pch=2,col=2)
for (i in 1:length(brca$log2S100A8)) lines(rep(brca$log2ESR1[i],2),c(mean(brca$log2S100A8),lm2$fitted[i]),lty=2,col=2)
```
## Kwadratensom van de fouten
$$ \text{SSE} = \sum_{i=1}^n (Y_i-\hat{Y}_i )^2 = \sum_{i=1}^n \left\{Y_i-\hat{g}\left(x_i\right)\right\}^2.$$
- Hoe kleiner de SSE, hoe beter het model fit.
- Kleinste kwadraten techniek!
***
```{r out.width='100%', fig.asp=.8, fig.align='center',echo=FALSE}
plot(log2S100A8~log2ESR1,brca,xlab="ESR1 expressie (log2)",ylab="S100A8 expressie (log2)",cex.axis=1.5,cex.main=1.5,cex.lab=1.5)
abline(lm2,col=2)
points(brca$log2ESR1,lm2$fitted,pch=2,col=2)
for (i in 1:length(brca$log2S100A8)) lines(rep(brca$log2ESR1[i],2),c(brca$log2S100A8[i],lm2$fitted[i]),lty=2)
```
We kunnen aantonen dat SST kan worden ontbonden in
\begin{eqnarray*}
\text{SSTot}
&=& \sum_{i=1}^n (Y_i-\bar{Y})^2 \\
&=& \sum_{i=1}^n (Y_i-\hat{Y}_i+\hat{Y}_i-\bar{Y})^2 \\
&=& \sum_{i=1}^n (Y_i-\hat{Y}_i)^2+\sum_{i=1}^n(\hat{Y}_i-\bar{Y})^2 \\
&=& \text{SSE }+\text{SSR}
\end{eqnarray*}
- De totale variabiliteit in de gegevens (SSTot) wordt gedeeltelijk verklaard door het regressieverband (SSR).
- Variabiliteit die we niet kunnen verklaren met het regressiemodel is de residuele variabiliteit (SSE).
## Determinatie-coëfficiënt
$$ R^2 = 1-\frac{\text{SSE}}{\text{SSTot}}=\frac{\text{SSR}}{\text{SSTot}}.$$
- *Fractie van de totale variabiliteit in de steekproef-uitkomsten die verklaard wordt door het geschatte regressieverband*.
- Grote $R^2$ indicatie dat model potentieel tot goede predicties kan leiden (kleine SSE)
- Slechts in beperkte mate indicatief voor de p-waarde van de test $H_0:\beta_1=0$ vs $H_1:\beta_1\neq0$.
- p-waarde sterk beïnvloed door SSE en steekproefgrootte $n$, maar niet door SSTot
- De determinatiecoëfficiënt $R^2$ wordt door SSE en SSTot bepaald, maar niet door de steekproefgrootte n.
- Model met lage $R^2$ blijft wel nuttig om associatie te bestuderen, zolang het de associatie correct modelleert!
### Borstkanker voorbeeld
```{r}
summary(lm2)
```
## F-Testen in het enkelvoudig lineair regressiemodel
- Kwadratensommen zijn basis voor $F$-tests
$$ F = \frac{\text{MSR}}{\text{MSE}}$$
met $\text{MSR} = \frac{\text{SSR}}{1} \text{ and } \text{MSE} = \frac{\text{SSE}}{n-2}.$
- MSR wordt de gemiddelde kwadratensom van de regressie genoemd.
- noemers 1 en $n-2$ zijn de vrijheidsgraden van SSR en SSE.
- onder $H_0: \beta_1=0$ volgt de teststatistiek
$$H_0:F = \frac{\text{MSR}}{\text{MSE}} \sim F_{1,n-2},$$
- F-test is altijd twee-zijdig! $H_1:\beta_1\neq 0$
$$ p = P_0\left[F\geq f\right]=1-F_F(f;1,n-2)$$
```{r}
summary(lm2)
```
```{r, echo=FALSE}
grid<-seq(0,10,.1)
plot(grid,df(grid,1,30),type="l",xlab="F",ylab="Density",main="F-distributie 1 df in tellen, 30 in noemer",cex.main=1.5,cex.axis=1.5,cex.lab=1.5)
```
## Anova Tabel
| |Df|Sum Sq|Mean Sq|F value|Pr(>F)|
|---|---|---|---|---|---|
|Regressie|vrijheidsgraden SSR|SSR|MSR|f-statistiek|p-waarde|
|Error|vrijheidsgraden SSE|SSE|MSE| | |
```{r}
anova(lm2)
```
# Dummy variabelen
- Lineaire regressiemodel voor het vergelijken van twee gemiddelden.
- Borstkanker: verschil is in gemiddelde leeftijd van de patiënten met onaangetaste lymfeknopen en patiënten waarvan lymfeknopen werden verwijderd.
- Hiervoor definiëren we eerst een $dummy$ variabele
$$x_i = \left\{ \begin{array}{ll}
1 & \text{aangetaste lymfeknopen} \\
0 & \text{onaangetaste lymfeknopen} \end{array}\right.$$
- groep met $x_i=0$ wordt de **referentiegroep** genoemd.
- Het regressiemodel blijft ongewijzigd,
$$Y_i = \beta_0 + \beta_1 x_i +\epsilon_i$$
met $\epsilon_i \text{ iid } N(0,\sigma^2)$
Gezien $x_i$ slechts twee waarden kan aannemen, is het eenvoudig om het regressiemodel voor beide waarden van $x_i$ afzonderlijk te bekijken:
$$ \begin{array}{lcll}
Y_i &=& \beta_0 +\epsilon_i &\text{onaangetaste lymfeknopen} (x_i=0) \\
Y_i &=& \beta_0 + \beta_1 +\epsilon_i &\text{ aangetaste lymfeknopen} (x_i=1) .
\end{array}$$
Dus
\begin{eqnarray*}
E\left[Y_i\mid x_i=0\right] &=& \beta_0 \\
E\left[Y_i\mid x_i=1\right] &=& \beta_0 + \beta_1,
\end{eqnarray*}
waaruit direct de interpretatie van $\beta_1$ volgt:
$$ \beta_1 = E\left[Y_i\mid x_i=1\right]-E\left[Y_i\mid x_i=0\right]$$
$\beta_1$ is dus het gemiddelde verschil in leeftijd tussen patiënten met aangetaste lymfeknopen en patiënten met onaangetaste lymfeknopen (referentiegroep).
Met de notatie $\mu_0= E\left[Y_i\mid x_i=0\right]$ en $\mu_1= E\left[Y_i\mid x_i=1\right]$ wordt dit
$$\beta_1 = \mu_1-\mu_0.$$
Er kan aangetoond worden dat
$$\begin{array}{ccll}
\hat\beta_0
&=& \bar{Y}_1&\text{ (steekproefgemiddelde in referentiegroep)} \\
\hat\beta_1
&=& \bar{Y}_2-\bar{Y}_1&\text{(schatter van effectgrootte)} \\
\text{MSE}
&=& S_p^2 .
\end{array}$$
De testen voor $H_0:\beta_1=0$ vs. $H_1:\beta_1\neq0$ kunnen gebruikt worden voor het testen van de nulhypothese van de two-sample $t$-test, $H_0:\mu_1=\mu_2$ t.o.v. $H_1:\mu_1\neq\mu_2$.
```{r}
brca$node <- as.factor(brca$node)
t.test(age~node,brca,var.equal=TRUE)
```
```{r}
lm3 <- lm(age~node, brca)
summary(lm3)
```
```{r}
plot(lm3)
```
```{r}
brca |>
ggplot(
aes(
x = node |>
as.factor(),
y = age)
) +
geom_boxplot()
```
1. Simulate 9 datasets with the same number of observations as the brca dataset from a normal distribution with the same standard deviation as in the original data. Store the data of all simulations in a data frame
2. Plot the simulated data using the `ggplot` function
3. Add a boxplot layer
4. Use facet_wrap to make a separate plot for simulated dataset
5. Change label of y-axis
```{r out.width='100%', fig.asp=.8, fig.align='center'}
set.seed(354)
sim_df <- data.frame(
node = rep(brca$node, 9),
iid = rnorm(9 * nrow(brca), sd = sigma(lm3)),
sim = rep(1:9, each = 32)
)
sim_df |>
ggplot(aes(x = node, y=iid)) +
geom_boxplot() +
facet_wrap(.~sim) +
ylab(paste0("iid N(0,",round(sigma(lm3)^2,2),")"))
```
## Observationele study
- We kunnen echter niet besluiten dat oudere personen een hoger risico hebben op aantasting van de lymfeknopen ten gevolge van hun leeftijd.
- Mogelijks **confounding**: geen randomisatie $\rightarrow$ groepen patiënten met aangetaste lymfeknopen en niet-aangetaste lymfeknopen kunnen nog in andere karakteristieken van elkaar verschillen.
- Enkel besluiten dat er een associatie is tussen de lymfeknoop status en de leeftijd.
- Het is dus niet noodzakelijkerwijs een causaal verband!
***
- Is ook zo voor lineair model voor de $\log_2$-S100A8-expressie.
- Aangezien we de ESR1-expressie niet experimenteel vast hebben kunnen leggen, kunnen we niet besluiten dat een hogere ESR1-expressie de S100A8-expressie doet verlagen.
- Enkel besluiten dat er een negatieve associatie is.
- Om impact van gen te bestuderen op andere genen: knockout mutanten generenen in het labo
***


